범용 AI가 화학 제품 선정에서 실패하는 이유
요약
특수화학 제품 선정에 AI를 검토하는 의사결정자는 측정할 수 있는 신뢰성 문제와 마주합니다. 2026년 10월 Vectara 리더보드에서 범용 대규모 언어 모델(LLM)은 문서 요약의 1.8~24.2%에서 환각, 즉 근거 없이 지어낸 내용을 보였습니다. 스탠퍼드 연구에서는 검색 기능을 갖춘 법률 AI 도구도 질의의 17~33%에서 여전히 환각을 보였고, 검색 없이 쓴 GPT-4는 43%였습니다. 원인은 구조에 있습니다. 학습과 평가 방식은 불확실하다고 인정하는 답보다 그럴듯한 추측에 점수를 주고(OpenAI, 2025), 범용 모델에는 제품 데이터시트, 안전보건자료(SDS), 상용성 표 같은 근거 출처가 없습니다. 이 글은 범용 모델이 화학 제품 선정의 어느 지점에서 무너지는지 설명하고, 사양, SDS, 상용성에 걸친 그라운딩 문제를 정의합니다. 이어서 모든 추천을 인용 출처에 묶는 도메인 그라운딩 검색 구조를 소개합니다. 벤더 검토에 바로 쓸 수 있도록 범용 모델과 그라운딩 시스템의 비교 매트릭스, 구매 담당자용 평가 체크리스트도 실었습니다. 결론은 하나입니다. AI 화학 제품 선정은 검증된 도메인 데이터에 근거해 검색하고, 모든 주장에 추적 가능한 인용을 붙일 때에만 믿을 수 있습니다.
목차
I. 서론
II. 범용 LLM이 화학 제품 선정에서 무너지는 지점
IV. 도메인 그라운딩 검색 구조
VI. 현장에서 보이는 패턴
VII. 핵심 정리
VIII. 참고 문헌
I. 서론
유통사와 구매팀이 제품 선정에 범용 AI 어시스턴트를 시험해 보기 시작하면서, 마케팅 주장보다 먼저 떠오르는 실무 질문이 있습니다. 답이 틀리면 안전, 규정 준수, 비용 문제로 이어지는데, 특수화학 제품 추천을 범용 모델에 맡겨도 되는가 하는 질문입니다.
근거를 보면 답은 그라운딩 없이는 안 된다입니다. 그라운딩은 답마다 검증된 출처 문서에 묶는 일입니다. 범용 모델은 검증된 제품 사실을 찾아오도록 만든 것이 아니라, 유창하고 그럴듯한 글을 쓰도록 설계됐습니다. 이 글은 화학 제품 선정에 AI 도입을 검토하는 의사결정자를 위해 썼습니다. 범용 모델이 어디서 실패하는지 수치로 보여 주고, 기술 구매 담당자가 직접 점검할 수 있는 말로 그라운딩 문제를 설명합니다. 도메인 그라운딩 검색 시스템이 신뢰성 판단을 어떻게 바꾸는지도 정리합니다.
II. 범용 LLM이 화학 제품 선정에서 무너지는 지점
범용 대규모 언어 모델이 화학 제품 선정에서 실패하는 이유는 두 가지입니다. 검증된 사실을 찾아오지 않고 통계적으로 그럴듯한 텍스트를 생성한다는 점, 그리고 제품 사양, 안전보건자료, 상용성 데이터를 근거로 찾아볼 수단이 없다는 점입니다. 2026년 10월에 갱신된 Vectara 문서 요약 리더보드에서는 등재된 111개 모델이 모델에 따라 요약의 1.8~24.2%에서 환각을 보였습니다(Vectara, 2026). 제품 선정에서는 검증할 수 없는 답의 오류율이 한 자릿수라도 운영상 받아들일 수 없습니다.
유창한 답이 왜 정확한 답은 아닌가요?
이 실패는 일시적인 품질 격차가 아니라 구조의 문제입니다. 범용 모델은 폭넓은 학습 데이터에서 익힌, 그럴듯한 텍스트가 나올 확률을 최대화합니다. 그래서 제품별 데이터가 부족해도 답을 사양하지 않고, 자신 있게 지어낸 답을 내놓습니다(OpenAI, 2025). 같은 연구에 따르면 정확도 중심의 표준 평가는 추측에 점수를 주고, "모르겠습니다"라는 정직한 답에는 불이익을 줍니다. 허세를 부릴 유인이 모델을 학습시키고 채점하는 방식에 처음부터 들어 있는 셈입니다(OpenAI, 2025).
화학 제품 선정에서 이것이 문제가 되는 까닭은 모델이 맞든 틀리든 답이 똑같이 유창하게 읽히기 때문입니다. 부식 방지제, 금속가공유, 코팅 시스템을 추천하는 글은 근거가 된 사양이 실제이든 지어낸 것이든 같은 권위를 띱니다. 그라운딩된 출처와 인용이 없으면, 구매 담당자는 결정하는 순간에 둘을 구별할 방법이 없습니다.
이런 모델은 실제로 얼마나 자주 틀리나요?
환각률은 이제 일화가 아니라 측정값이고, 최상위 모델에서도 무시할 수 없는 수준입니다. 아래 표는 2024~2026년 벤치마크 수치를 모은 것입니다. 평가 담당자는 도메인 튜닝 전의 기본 위험을 이 표로 가늠할 수 있습니다.
그림 1. 범용 LLM의 환각률 측정치
벤치마크와 연도 | 측정한 작업 | 보고된 환각률 |
|---|---|---|
Vectara HHEM 리더보드(2026년 10월) | 문서 요약, 원문 충실도 | 111개 모델에서 1.8~24.2% |
스탠퍼드 법률 연구(Magesh et al., 2025) | 범용 GPT-4, 법률 질의 | 질의의 43% |
Vectara 리더보드에서 요약 오류율이 가장 낮은 모델은 1.8%였고, 널리 쓰이는 모델 상당수는 10% 안팎이거나 그 이상이었습니다(Vectara, 2026). 전문 질의에 대한 범용 추론은 더 나빠서, 검색 없이 쓴 GPT-4는 법률 질의의 43%에서 환각을 보였습니다(Magesh et al., 2025). 화학 제품 선정과 가장 비슷한 사례는 이 법률 수치입니다. 둘 다 위험이 큰 전문 분야이고, 그럴듯하지만 틀린 답이 실제 결과로 이어지기 때문입니다.
III. 그라운딩 문제: 사양, SDS, 상용성
그라운딩(grounding)은 생성된 답이 모델 내부의 파라미터, 곧 학습 중에 기억한 패턴이 아니라 검색해 온 검증 가능한 출처 문서에서 얼마나 나왔는지를 말합니다. 화학 제품 선정에서 범용 모델은 그라운딩이 약합니다. 제품 사양, 안전보건자료(SDS), 상용성 표라는 세 가지 권위 있는 데이터가 학습 데이터에 믿을 만하게 들어 있지 않고, 답을 만들 때 검색해 오지도 않기 때문입니다. 올바르게 선정하려면 출처가 분명한 최신 자료가 세 가지 모두 필요합니다.
사양과 SDS 데이터는 왜 일반화하기 어렵나요?
제품 사양은 정밀하고, 개정판이 있으며, 공급사마다 다릅니다. 점도 등급, 인화점, pH, 유효 성분 농도, 사용 온도 범위는 제품과 개정판에 따라 달라지는 정확한 값입니다. 모델이 일반 학습 데이터로 이 값을 어림하면 그럴듯해 보여도 실제 데이터시트 어디에도 맞지 않을 수 있는 숫자가 나옵니다.
안전보건자료는 문제를 더 키웁니다. 비상용성 정보는 SDS 7항(취급 및 저장)과 10항(안정성 및 반응성)에 있는데, 같은 화학물질이라도 공급사마다 SDS 내용이 서로 어긋날 수 있습니다(eTrain Today, 2026).
SDS 출처가 서로 어긋날 때 권장되는 안전 관행은, 불일치를 조정하고 기록할 때까지 가장 보수적인 상용성 분류에 맞춰 저장하는 것입니다(eTrain Today, 2026). 범용 모델에는 두 출처가 어긋난다는 사실을 알아차리거나, 충돌을 표시하거나, 보수적인 해석을 기본값으로 삼는 장치가 없습니다. 어긋나는 입력을 섞어 유창한 답 하나로 만들어 버립니다. 그라운딩이 막으려는 실패가 바로 이것입니다.
상용성은 왜 결과가 가장 큰 공백인가요?
선정 오류가 곧바로 물리적 위험으로 바뀌는 곳이 상용성입니다. 서로 상용성이 없는 화학물질은 반응해 열, 화재, 폭발, 유독 가스, 부식성 물질, 위험한 압력 상승을 일으킬 수 있습니다(Alliance Chemical, 2026). 비상용성 하나를 놓친 추천은 다음 개정 때 다듬으면 되는 품질 결함이 아니라 위험 요인입니다. 인용된 상용성 출처가 없는 범용 모델의 답이 산업 현장의 선정 결정에 부적합한 핵심 이유가 여기에 있습니다. 검증된 상용성 데이터에 그라운딩하는 일이 선택이 아니라 필수인 이유도 같습니다.
IV. 도메인 그라운딩 검색 구조
도메인 그라운딩 검색 구조는 언어 모델에 선별하고 검증한 화학 지식 베이스를 붙인 구조입니다. 추천을 모델의 기억으로 생성하지 않고, 모두 출처 문서에서 검색해 오고 그 문서를 인용합니다. 이를 구현하는 확립된 방법이 검색 증강 생성(RAG)입니다. 모델과 외부 검색 시스템을 결합해 사실 근거를 강화하고 환각을 줄입니다(arXiv survey, 2025). 모든 주장을 구매 담당자가 직접 확인할 수 있는 출처까지 추적할 수 있으니, 신뢰성 판단이 달라집니다.
검색 그라운딩은 신뢰성 판단을 어떻게 바꾸나요?
그라운딩을 하면 모델은 답을 쓰는 저자가 아니라, 검색해 온 근거를 요약하는 역할을 맡습니다. 시스템은 점도 값을 기억에서 만들어 내지 않고, 관련 데이터시트 구절을 검색해 와서 답을 그 구절 안으로 제한합니다. 그래서 결과를 인용된 출처와 대조해 확인할 수 있습니다. 그라운딩 점수는 답이 모델 파라미터가 아니라 검색해 온 문서에서 얼마나 나왔는지를 재며, 점수가 높으면 시스템이 의도대로 작동하고 있다는 신호입니다(Maxim AI, 2025).
평가 담당자는 기대치를 현실적으로 잡아야 합니다. 그라운딩은 필요조건이지만 충분조건은 아닙니다. 스탠퍼드 연구에서는 검색 기반 상용 법률 도구도 두 제품은 질의의 17%, 다른 한 제품은 33%에서 여전히 환각을 보였습니다(Magesh et al., 2025). 검색만으로 오류가 사라지지는 않습니다. 최종 신뢰성은 검색의 품질, 출처 코퍼스의 선별, 모든 주장을 인용하는 원칙이 정합니다. 검색 결과의 잡음, 그리고 검색해 온 근거와 생성된 텍스트 사이의 불일치도 여전히 환각으로 이어질 수 있습니다(arXiv survey, 2025).
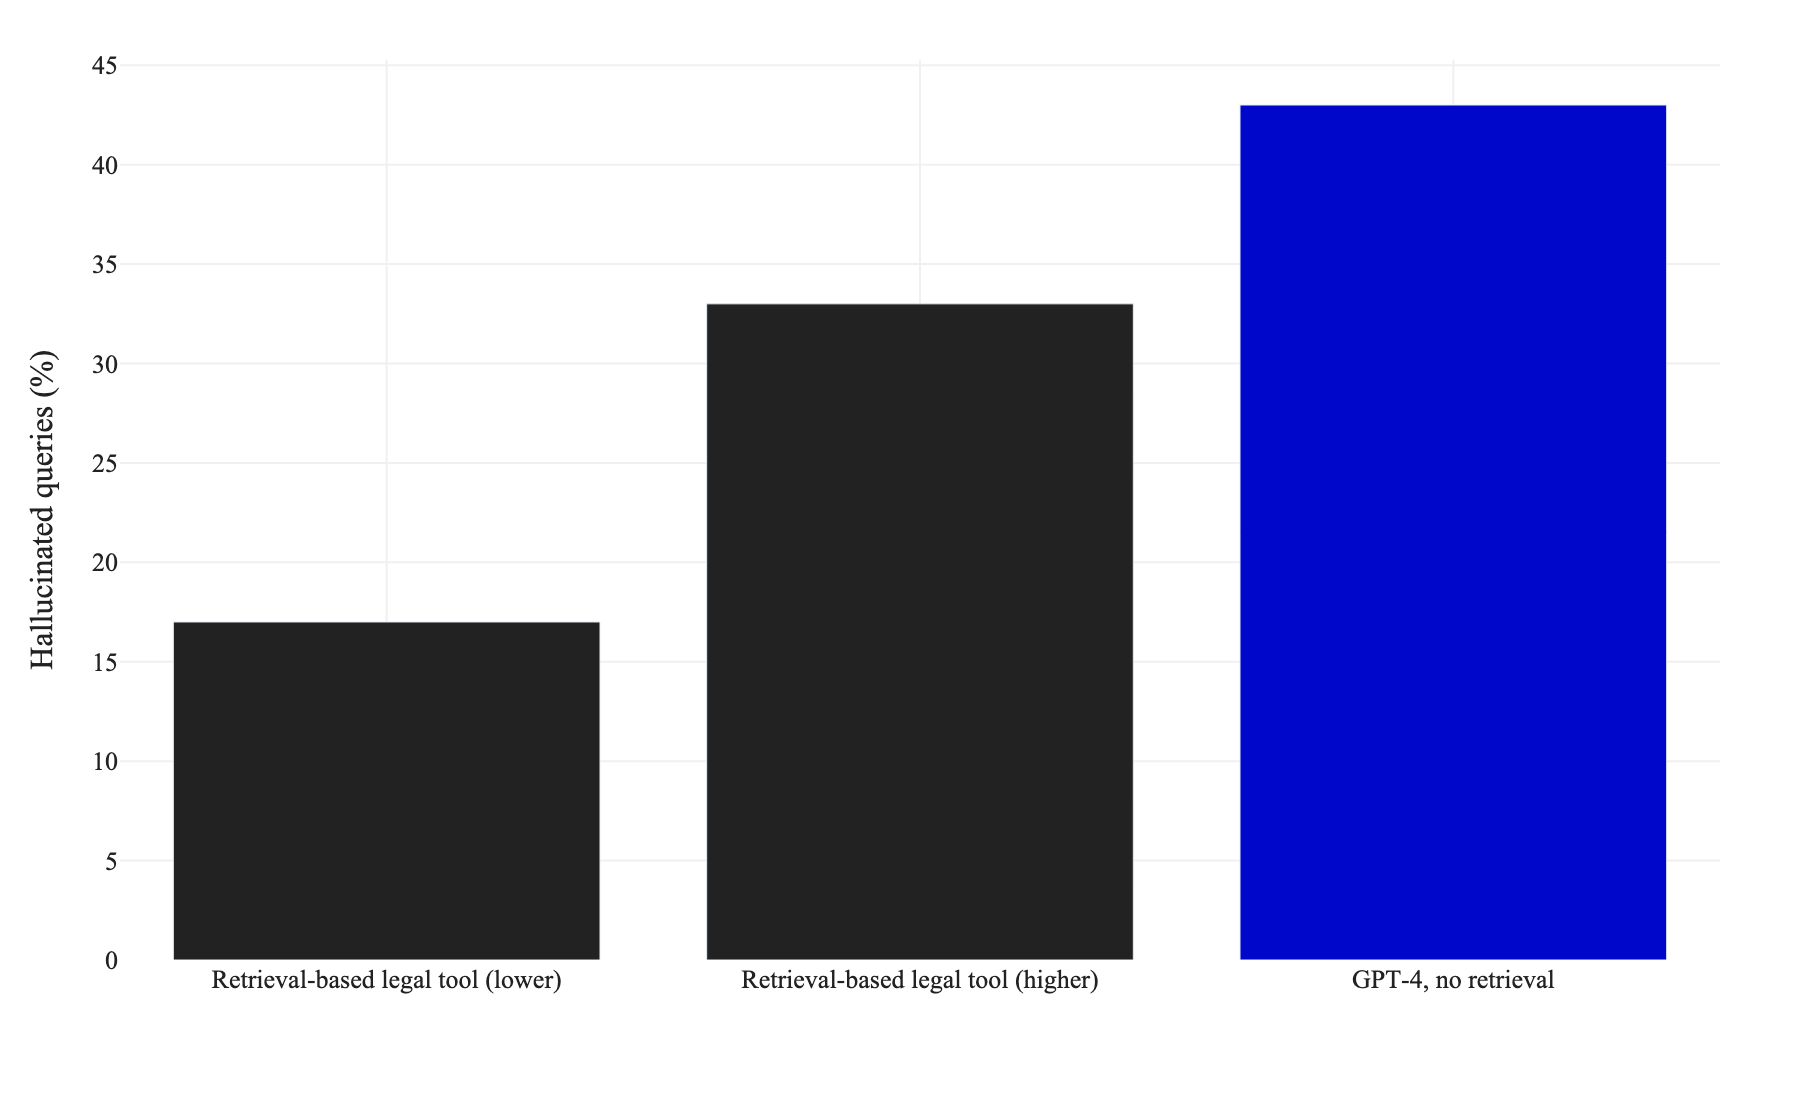
그림 2. 검색은 환각을 줄이지만 없애지는 못합니다: 검색 없이 쓴 GPT-4와 검색 기반 상용 법률 도구 두 가지의 벤치마크 질의 가운데 환각 답변 비율. 출처: 스탠퍼드 연구(Magesh et al., 2025).
도메인 튜닝은 일반 검색에 무엇을 더하나요?
도메인 튜닝은 전문 용어에서 검색 정밀도를 높일 수 있고, 화학 제품 선정은 바로 그 전문 용어의 영역입니다. 검색기는 키워드 검색과 벡터 검색을 함께 쓸 수 있고, 검색해 온 문서를 재순위화(reranking)하면 RAG 시스템의 충실도가 높아집니다(arXiv survey, 2025). 화학 분야에서 까다로운 용어는 특정 제품군, 상품 표기, 반응성 용어이며, 범용 검색기는 이런 용어를 제대로 색인하지 못할 수 있습니다.
구매 담당자가 구조에서 얻을 결론은 출처 코퍼스가 모델만큼 중요하다는 점입니다. 그라운딩 시스템의 신뢰성은 검색 대상인 사양, SDS 기록, 상용성 표의 수준을 넘지 못하며, 이 자료는 검증되고 버전 관리되어야 합니다. 평가 담당자가 기억할 원칙은 이것입니다. 추천은 인용되고 검증 가능한 출처에 묶여 있을 때에만 믿을 수 있습니다.
V. 구매 담당자를 위한 평가 기준
AI 화학 제품 선정 도구를 평가할 때는 네 가지를 봐야 합니다. 모든 추천이 검증 가능한 출처에 근거하는지, 시스템이 그 출처를 인용하는지, 어긋나거나 빠진 데이터를 표시하는지, 근거가 부족할 때 답을 보류하는지입니다. 인용도 없고 답변 보류(답하기를 거절하는 일)도 없이 모든 질문에 유창하게 답하는 도구는, 벤치마크가 측정하는 바로 그 실패를 보이고 있습니다. 아래 두 가지 판단 도구는 벤더 검토용으로 만들었습니다.
범용 모델과 그라운딩 시스템 비교 매트릭스
이 매트릭스는 선정 결정의 신뢰성을 좌우하는 항목별로 두 구조를 비교합니다. 벤더를 나란히 놓고 비교할 때 틀로 쓰면 됩니다.
그림 3. 범용 LLM과 도메인 그라운딩 검색 비교
항목 | 범용 LLM | 도메인 그라운딩 검색 |
|---|---|---|
답의 출처 | 모델 파라미터(학습으로 기억한 내용) | 검색해 와 인용한 출처 문서 |
사양과 SDS 처리 | 어림한 값, 실제 데이터시트와 맞지 않을 수 있음 | 검증되고 버전 관리되는 기록에서 검색 |
출처가 어긋날 때 | 표시 없이 섞어 답 하나로 만듦 | 충돌을 표시하고 보수적인 해석을 기본값으로 삼음 |
근거가 없을 때 | 그럴듯한 추측을 생성 | 답을 보류하거나 불확실하다고 밝힘 |
결정적인 차이는 유창함이나 속도가 아니라 추적 가능성과 정직한 답변 보류입니다. 그라운딩 시스템은 주장마다 출처를 가리키므로 점검할 수 있습니다. 범용 시스템의 답은 들여다볼 수 없는 모델의 기억에서 나오므로 점검할 수 없습니다. 가장 가치 있는 시험 항목은 출처가 어긋날 때와 근거가 없을 때의 두 행입니다. 도구가 안전과 직결된 분야를 위해 만들어졌는지, 범용 어시스턴트를 고쳐 쓴 것뿐인지가 여기서 드러납니다.
구매 담당자용 평가 체크리스트
아래 체크리스트는 합격과 불합격만 가리는 선별 기준입니다. 벤더 데모가 아니라 회사의 실제 선정 질문으로 후보 도구를 항목마다 시험합니다.
인용 제시: 모든 제품 추천이 특정 출처 문서를 인용하고, 구매 담당자가 열어서 확인할 수 있는 구절을 제시하나요? 일반적인 면책 문구가 아니라 모든 주장에 인용이 있어야 합격입니다.
출처 검증 가능성: 인용된 사양 값이나 SDS 값을 실제 공급사 데이터시트와 대조해 확인할 수 있나요? 인용된 값이 출처와 일치해야 합격입니다.
충돌 처리: 서로 어긋나는 SDS 두 건을 입력했을 때, 도구가 충돌을 표시하고 보수적인 해석을 기본값으로 삼나요? 충돌을 명시적으로 감지해야 합격입니다(eTrain Today, 2026).
정직한 답변 보류: 코퍼스에 없는 제품이나 조건을 물었을 때, 도구가 추측하지 않고 답을 보류하거나 불확실하다고 밝히나요? 보정된 동작에 맞게 답을 보류해야 합격입니다(OpenAI, 2025).
상용성 그라운딩: 모든 상용성 진술이 생성된 주장이 아니라 검증된 상용성 출처로 추적되나요? 물리적 위험으로 이어지는 결과를 고려하면 이 항목은 반드시 통과해야 합니다(Alliance Chemical, 2026).
도메인 검색 품질: 드물게 쓰이는 전문 제품 용어에서도 검색이 올바른 기록을 찾아오나요? 회사가 가진 가장 어려운 실제 질의에서 올바르게 검색해야 합격입니다(arXiv survey, 2025).
1, 4, 5번 항목에서 떨어진 도구는 유창함이나 답변 범위가 아무리 좋아도 제품 선정 용도에서 탈락시켜야 합니다. 그라운딩된 추천과 자신 있는 추측을 가르는 것이 이 세 항목이기 때문입니다.
VI. 현장에서 보이는 패턴
앞의 벤치마크에서 세 가지 패턴이 나옵니다. 화학 제품 선정에서 버틸 가능성이 높은 도구와 그렇지 못한 도구가 이 패턴으로 갈립니다. 특정 사례가 아니라 업계 수준의 패턴으로 정리했습니다.
유창함의 함정
첫째는 유창함의 함정입니다. 범용 어시스턴트가 권위 있게 읽히는 선정 조언을 내놓고, 팀이 이를 검증 없이 받아들이는 경우입니다. 맞는 답과 틀린 답은 겉보기에 똑같습니다. 그래서 잘못된 점도 등급이나 표시되지 않은 비상용성 같은 불일치가 나중에 드러나기 전까지, 팀은 결과를 지나치게 믿을 수 있습니다. 대응책은 절차에 있습니다. 모든 추천에 인용을 요구하고, 행동하기 전에 출처와 대조해 확인해야 합니다. 비교 매트릭스에서 그라운딩 도구를 가르는 것과 같은 원칙입니다.
검색으로 충분하지 않은 패턴
둘째 패턴은 검색 기능을 갖춘 도구라면 모두 저절로 안전하다고 여길 때 나타납니다. 검색 기반 법률 도구도 질의의 17~33%에서 여전히 환각을 보였다는 스탠퍼드 연구 결과가 이 점을 경고합니다(Magesh et al., 2025). 화학 제품 선정에서도 출처 코퍼스가 빈약하거나, 오래됐거나, 제대로 선별되지 않았다면 같은 격차가 생길 수 있습니다. 검색이 약한 근거를 가져오면 모델은 추측으로 빈자리를 채웁니다. 대응책은 코퍼스를 직접 시험하는 것입니다. 회사의 가장 어려운 질의로 구매 담당자용 체크리스트 2번과 6번 항목을 돌려 보면 됩니다.
보수적 기본값 패턴
셋째는 긍정적인 패턴으로, 성숙한 도구를 가려 줍니다. 잘 만든 그라운딩 시스템은 출처가 어긋나거나 근거가 없을 때 조용히 결론을 내지 않습니다. 보수적인 해석을 기본값으로 삼고 공백을 표시합니다. SDS 불일치를 조정할 때까지 가장 보수적인 상용성 분류에 맞춰 저장하는 확립된 안전 관행과 같은 방식입니다(eTrain Today, 2026). 벤더 시험에서 이렇게 동작하는 도구는 연구가 환각을 피하는 방법으로 꼽는 동작, 곧 불확실할 때 답을 보류하는 동작을 보여 주고 있습니다(OpenAI, 2025).
VII. 핵심 정리
범용 LLM은 측정 가능한 비율로 환각을 보입니다. 요약 리더보드에서는 1.8~24.2%, 검색 없이 쓴 GPT-4는 법률 질의에서 43%였습니다. 학습과 평가가 정직하게 불확실성을 밝히는 답보다 그럴듯한 추측에 점수를 주기 때문입니다(Vectara, 2026; Magesh et al., 2025; OpenAI, 2025). 인용 없는 유창한 답은 모두 검증되지 않은 답으로 다뤄야 합니다.
화학 제품 선정의 그라운딩 문제는 세 부분으로 나뉩니다. 정확한 사양, 서로 어긋나는 안전보건자료, 결과가 큰 상용성 데이터입니다. 범용 모델은 세 가지 모두 근거로 찾아볼 수단이 없고, 상용성 오류는 물리적 위험으로 이어집니다(eTrain Today, 2026; Alliance Chemical, 2026).
도메인 그라운딩 검색은 모든 주장을 인용되고 검증 가능한 출처에 묶어 신뢰성 판단을 바꿉니다. 그러나 검색만으로는 충분하지 않습니다. 최종 신뢰성은 코퍼스 선별, 도메인 튜닝 검색, 인용 원칙이 정합니다(arXiv survey, 2025; Magesh et al., 2025).
범용 모델과 그라운딩 시스템 비교 매트릭스, 그리고 6개 항목의 구매 담당자용 체크리스트로 벤더를 평가합니다. 인용, 정직한 답변 보류, 상용성 그라운딩 가운데 하나라도 떨어진 도구는 유창함과 상관없이 탈락시켜야 합니다.
평가는 벤더 데모가 아니라 회사의 가장 어렵고 실제적인 선정 질문으로 진행해야 합니다. 실패 유형은 출처가 어긋나거나 근거가 없는 입력에서 가장 분명하게 드러납니다.
VIII. 참고 문헌
[1] Alliance Chemical, "Chemical Compatibility Chart Guide: Safe Storage and Handling", 2026. https://alliancechemical.com/blogs/articles/chemical-compatibility-chart-guide-safe-storage-handling
[2] arXiv, "Retrieval-Augmented Generation: A Comprehensive Survey of Architectures, Enhancements, and Robustness Frontiers", 2025. https://arxiv.org/html/2506.00054v1
[3] eTrain Today, "6 Ways to Reconcile SDS Inconsistencies and Strengthen Chemical Storage Safety", 2026. https://etraintoday.com/blog/6-ways-to-reconcile-sds-inconsistencies-and-strengthen-chemical-storage-safety/
[4] Magesh, V., Surani, F., Dahl, M., Suzgun, M., Manning, C. D., and Ho, D. E., "Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools", Journal of Empirical Legal Studies, 2025. https://dho.stanford.edu/wp-content/uploads/Legal_RAG_Hallucinations.pdf
[5] Maxim AI, "Complete Guide to RAG Evaluation: Metrics, Methods, and Best Practices for 2025", 2025. https://www.getmaxim.ai/articles/complete-guide-to-rag-evaluation-metrics-methods-and-best-practices-for-2025/
[6] OpenAI, "Why Language Models Hallucinate", 2025. https://openai.com/index/why-language-models-hallucinate/
[7] Vectara, "Hallucination Leaderboard", 2026. https://github.com/vectara/hallucination-leaderboard/
2026-10-30 업데이트: 수치와 출처를 확인하고, 오래된 제품 언급을 삭제했습니다
